与语音助手交谈时,我们会停下来想一想,会说“嗯”“对”,也会临时改主意。身边的人、车载导航或会议里的其他声音,还可能同时进入麦克风。一个能够持续参与交流的系统,需要判断这些声音与当前对话的关系:什么时候继续说,什么时候等待,什么时候把话语权交还给用户。
MOSS-Live 将这种交互判断作为核心能力。根据 MOSS 官网公布的评测,它在六项全双工指标上均位居图中参评模型首位。与 GPT-Live-1 和豆包(Doubao SeedDuplex)相比,最显著的差距出现在无关语音处理和打断判断上。工具调用与多轮任务则呈现出不同的优势分布。
官方图表所列全双工指标,MOSS-Live 均居参评模型首位。
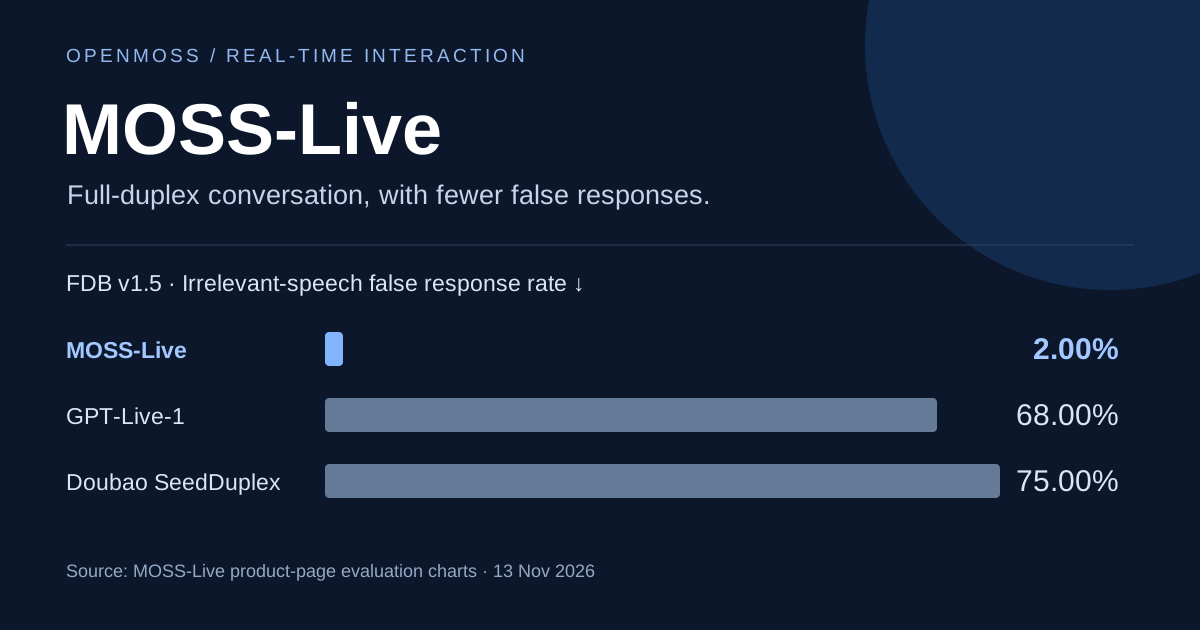
无关语音误接话率;GPT-Live-1 为 68%,豆包为 75%。
停顿抢话率;GPT-Live-1 为 10.37%,豆包为 14.29%。
与 GPT-Live、豆包相比,优势在哪里?
下面按原图中的具体名称列出 GPT-Live-1、Doubao SeedDuplex、GPT Realtime 2.1,避免把不同模型版本混为一谈。箭头表示优化方向:↓ 越低越好,↑ 越高越好;粗体表示表中该项最佳结果,包含并列。
全双工:减少抢话、误接话和无效打断
| 基准 / 指标 | MOSS-Live | GPT-Live-1 | Doubao SeedDuplex | GPT Realtime 2.1 |
|---|---|---|---|---|
| FDB v1 停顿抢话率(不含附和) ↓ | 1.44% | 10.37% | 14.29% | 3.83% |
| FDB v1.5 无关语音误接话率 ↓ | 2.00% | 68.00% | 75.00% | 72.00% |
| FDB v1.5 无关打断拒识率 ↑ | 68.00% | 21.00% | 13.00% | 5.00% |
| τ-Voice 附和抗干扰率 ↑ | 98.17% | 91.57% | 93.52% | 56.26% |
| τ-Voice 口头语抗干扰率 ↑ | 82.16% | 48.48% | 69.66% | 57.75% |
| τ-Voice 无关语音抗干扰率 ↑ | 78.90% | 66.99% | 60.42% | 27.10% |
来源:MOSS-Live 官网全双工能力评测图。原图还包含 Qwen Audio 3.0 Plus 和 Flash;MOSS-Live 在上述六项中也均领先这两款模型。
无关语音误接话率的差距最为突出:MOSS-Live 为 2%,比 GPT-Live-1 和豆包分别低 66 和 73 个百分点。停顿抢话率则分别低 8.93 和 12.85 个百分点。这两类指标对应常见的交互问题:用户尚在思考时,系统是否过早接话;声音并非对系统说时,系统是否仍然作答。
另一组结果考察说话过程中受到干扰后的表现。MOSS-Live 的无关打断拒识率为 68%,GPT-Live-1 和豆包分别为 21% 和 13%;附和抗干扰率达到 98.17%。这些结果支持的判断是:在本次评测中,MOSS-Live 更能维持对话节奏,并区分附和、无关声音与需要响应的输入。
工具与任务:工具调用并列第一,多轮任务仍有差距
| 基准 / 指标 | MOSS-Live | GPT-Live-1 | Doubao SeedDuplex | GPT Realtime 2.1 |
|---|---|---|---|---|
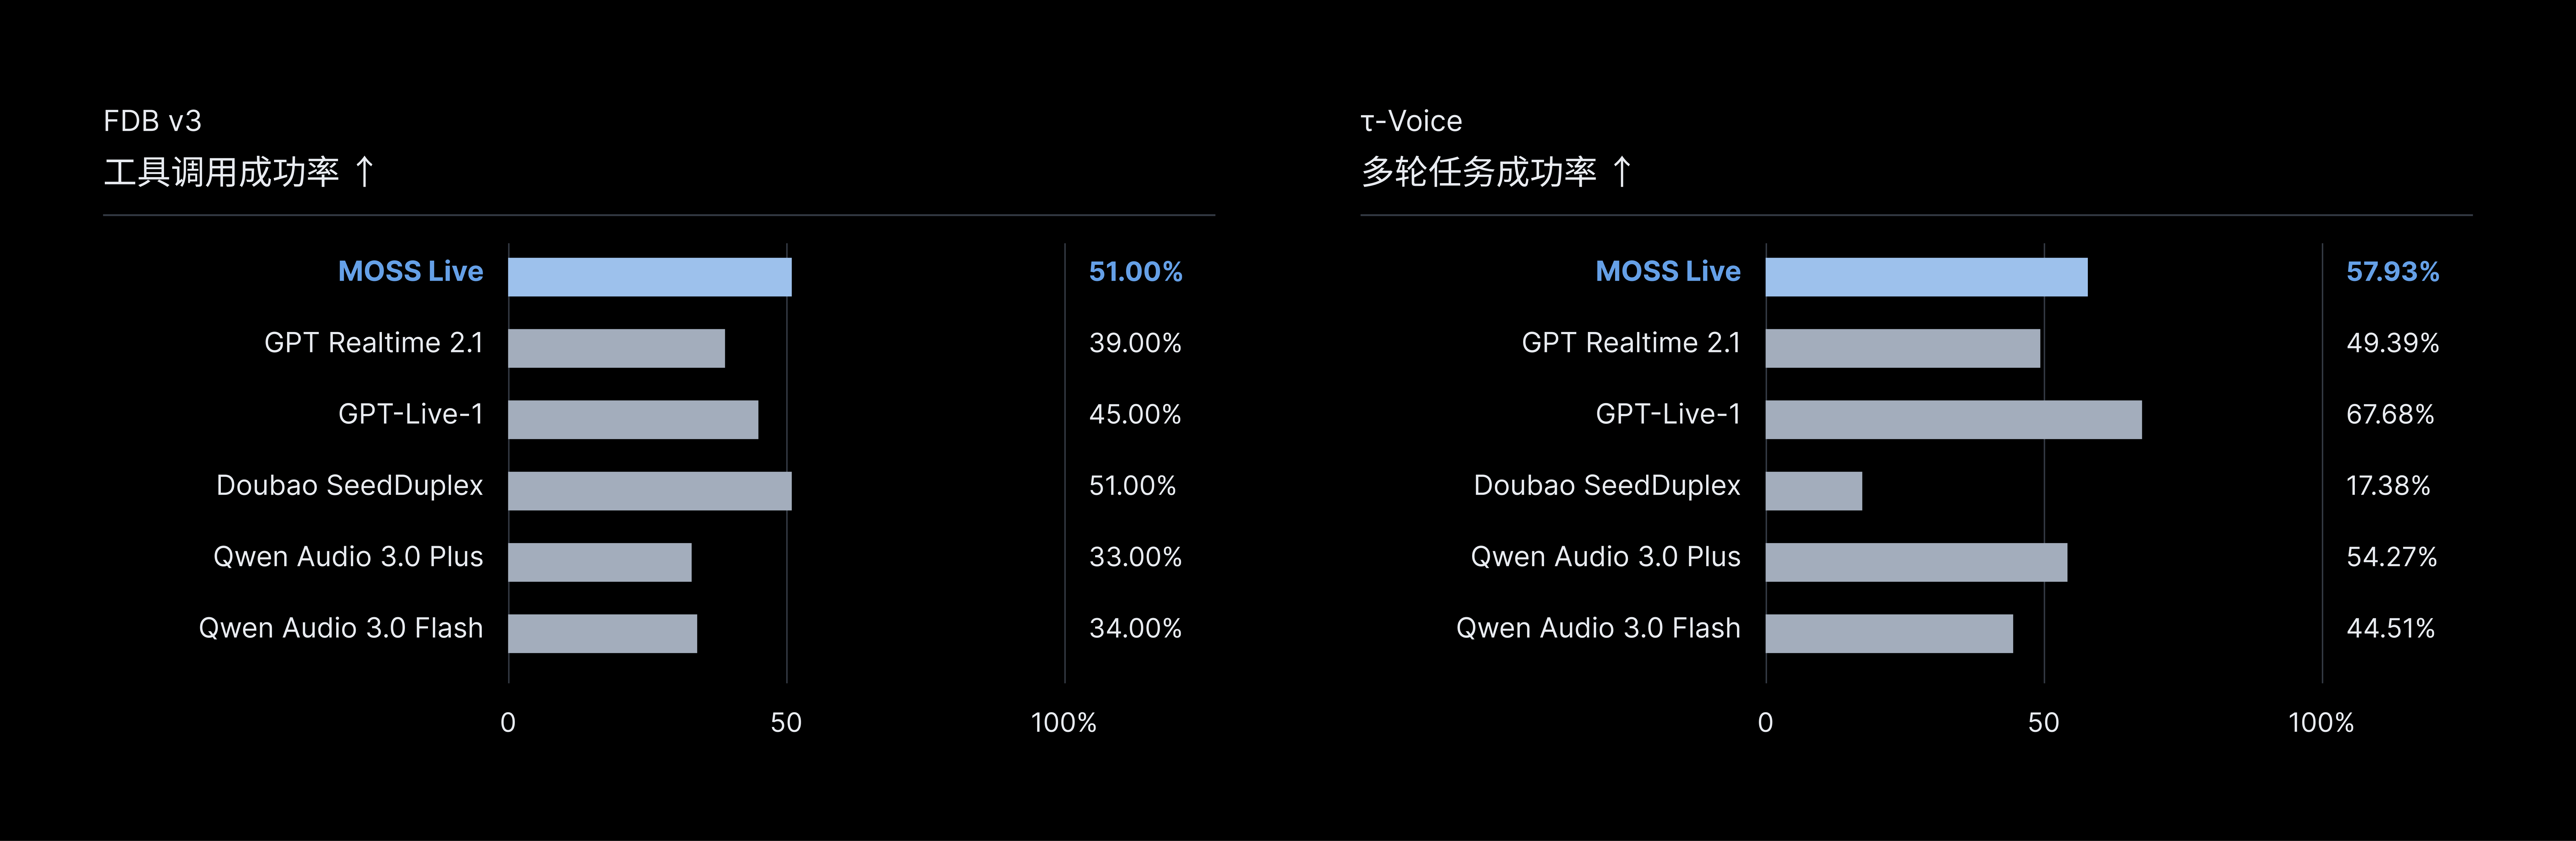
| FDB v3 工具调用成功率 ↑ | 51.00% | 45.00% | 51.00% | 39.00% |
| τ-Voice 多轮任务成功率 ↑ | 57.93% | 67.68% | 17.38% | 49.39% |
FDB v3 工具调用成功率上,MOSS-Live 达到 51%,高于 GPT-Live-1 的 45%,与豆包并列最高。τ-Voice 多轮任务成功率为 57.93%,较豆包的 17.38% 高出 40.55 个百分点,在原图六款模型中排名第二;GPT-Live-1 以 67.68% 领先,MOSS-Live 与它相差 9.75 个百分点。
这一区别很关键:能否自然地交流,与能否完成多轮任务,需要分别检验。MOSS-Live 的全双工优势十分明确,而涉及持续规划和任务完成时,GPT-Live-1 在这项评测中仍然更强。
理解与对话:打断后接续突出,部分指标仍需提升
| 基准 / 指标 | MOSS-Live | GPT-Live-1 | Doubao SeedDuplex | GPT Realtime 2.1 |
|---|---|---|---|---|
| Big-Bench Audio 总体准确率 ↑ | 88.40% | 80.80% | 90.50% | 90.10% |
| FDB v2 多轮指令遵循 ↑ · /5 | 3.35 | 3.72 | 3.44 | 3.36 |
| FDB v2 实体跟踪、纠错与安全 ↑ · /5 | 3.63 | 3.50 | 3.15 | 2.97 |
| FDB v1 打断后回答质量 ↑ · /5 | 4.88 | 4.67 | 4.51 | 4.57 |
MOSS-Live 的打断后回答质量为 4.88/5,实体跟踪、纠错与安全为 3.63/5,均为原图参评模型最高。与前面的抗干扰结果结合看,它的强项在于维持交流的连贯性:对话被插入、修正之后,仍能跟踪信息并继续回答。
同时,Big-Bench Audio 准确率为 88.40%,低于豆包的 90.50%;多轮指令遵循为 3.35/5,低于 GPT-Live-1 的 3.72/5 和豆包的 3.44/5。因此,本文的结论聚焦于全双工交互及对话接续的优势,不将这些结果扩展为所有语音能力的统一排名。
边交流、边执行:前后台如何协同?
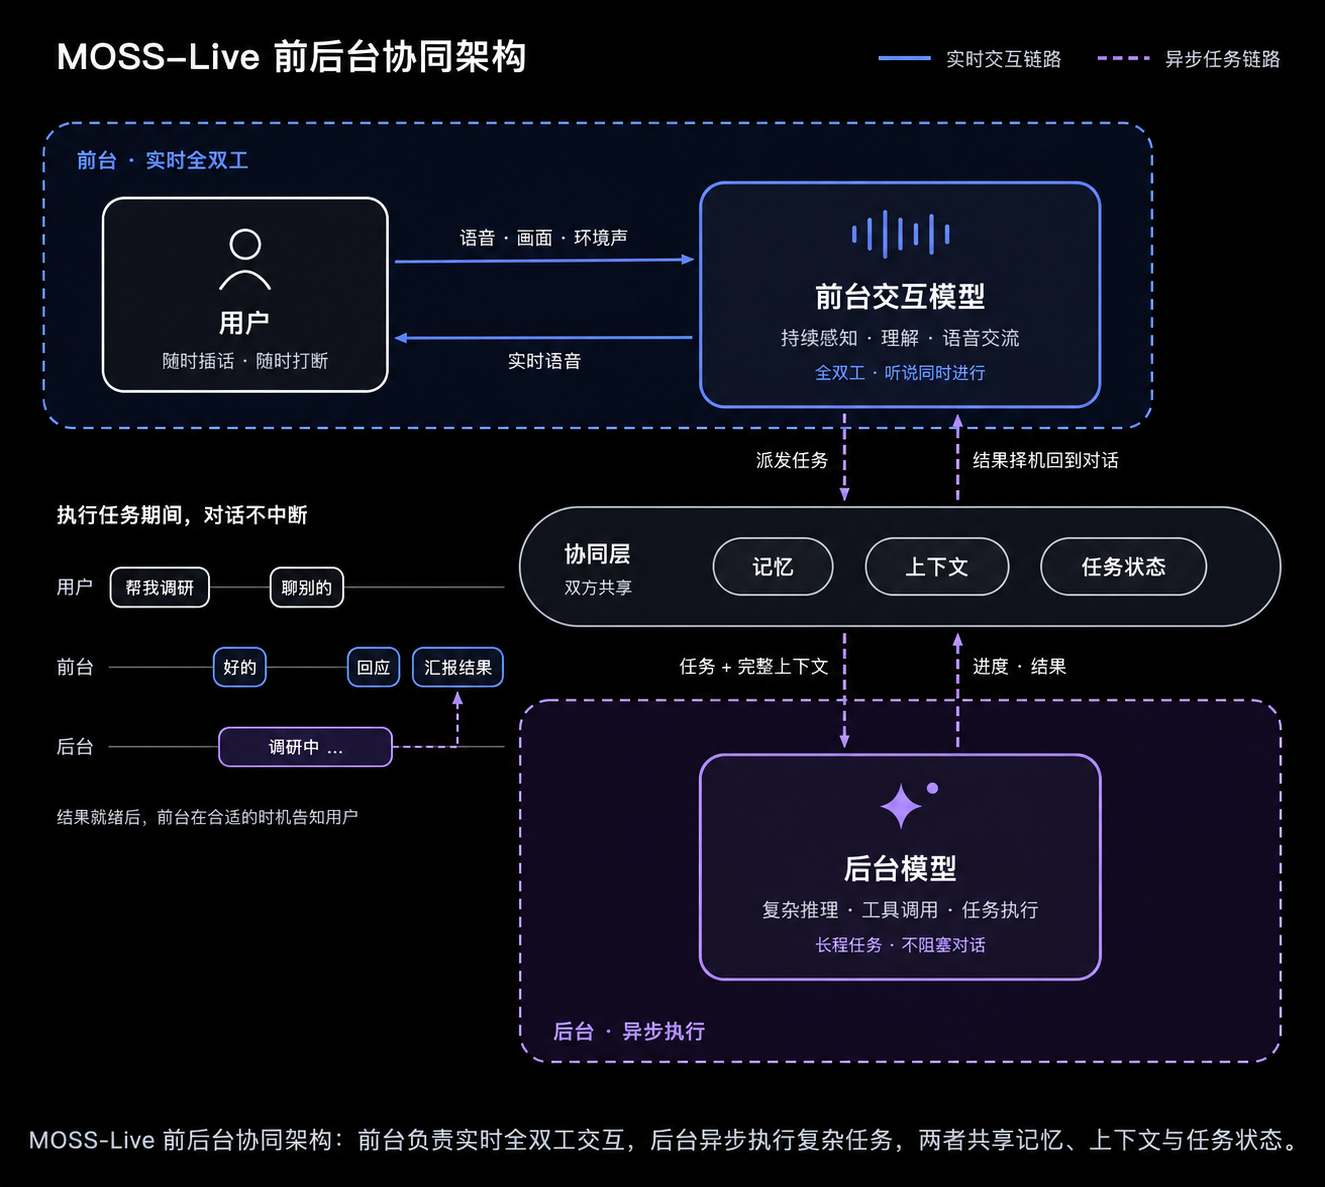
MOSS-Live 支持全双工语音、语义打断、实时视频和屏幕共享,以及流式同声传译。它将实时交互与耗时任务分工处理:前台负责持续感知和交流,后台承担复杂推理、工具调用与任务执行,协同层在两者之间共享记忆、上下文及任务状态。
例如,用户正在讨论旅行计划时,可以同时交办酒店查询,随后继续补充行程偏好。查询在后台推进,前台继续对话,结果就绪后再带回交流。这种设计让等待工具结果的时间能够被用于继续沟通,也让新需求有机会进入正在推进的任务。
在连续对话里观察这些能力
评测给出可对照的数值,演示则帮助观察具体的交互过程。以下为官网提供的三个场景;观看时可以重点留意附和是否造成中断、新需求如何被接收,以及话题切换后如何返回原任务。
多人会议:讨论和查询同时推进
自驾游规划:临时改需求,再接回原话题
上海旅行:结合实时画面继续交流
如何理解这组结果
如果应用最关心的是多人环境里的误接话、说话中的干扰和打断后的接续,MOSS-Live 的评测结果值得重点考察。如果更关心复杂多轮任务完成率,GPT-Live-1 在 τ-Voice 上的领先同样应该纳入判断;如果侧重语音理解准确率,豆包在 Big-Bench Audio 上的优势也应保留。
本文数据和模型名称均按 MOSS 官网在 2026 年 11 月 13 日展示的图表整理,属于产品方公布的评测。页面未展开样本量、误差范围、API 快照及完整评测配置。不同基准的指标不应混合计算总分;尤其 FDB v1.5 与 τ-Voice 的无关语音指标并非互补比例。本文不据此比较延迟、价格或所有场景下的产品体验。